
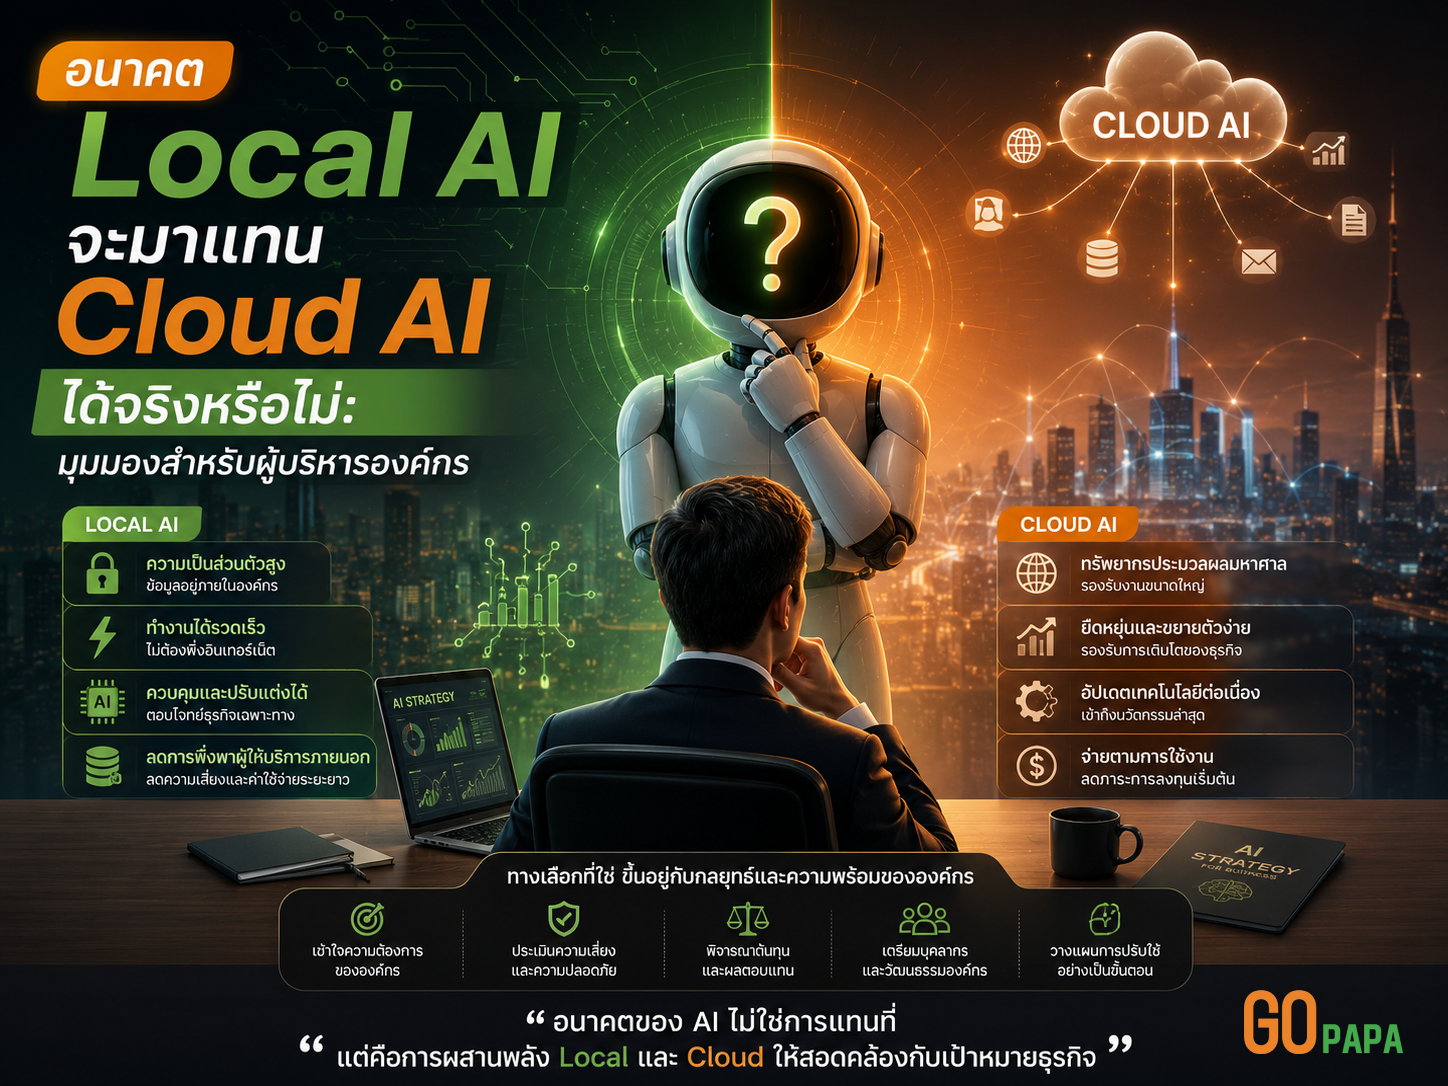
คำถามที่ผู้บริหารหลายคนถามในปี 2026 ไม่ใช่ “ควรใช้ AI หรือไม่” อีกต่อไป แต่เป็น “AI ขององค์กรเราควรรันอยู่ที่ไหน” ระหว่างการพึ่งพา Cloud AI จากผู้ให้บริการรายใหญ่ กับการนำโมเดล AI มารันเองบนโครงสร้างพื้นฐานภายในองค์กร (Local หรือ On-premise AI)
คำตอบสั้นๆ คือ ไม่ใช่การแทนที่กันแบบเบ็ดเสร็จ แต่เป็นการที่ทั้งสองแนวทางกำลังหลอมรวมเข้าด้วยกันเป็นสถาปัตยกรรมแบบ Hybrid ซึ่งกลายเป็นรูปแบบมาตรฐานขององค์กรขนาดใหญ่ไปแล้วในปัจจุบัน ไม่ใช่แค่แนวโน้มในอนาคต
บทความนี้จะพาผู้บริหารทำความเข้าใจสถานการณ์จริง กรอบการตัดสินใจที่ใช้ได้จริง และตัวอย่างองค์กรที่นำไปปรับใช้แล้ว
ทำไมคำถามนี้ถึงสำคัญตอนนี้
ในช่วง 18 เดือนที่ผ่านมา โมเดล AI แบบ open-weight อย่าง Llama, Qwen, Mistral และ DeepSeek พัฒนาขึ้นอย่างก้าวกระโดด จนสามารถรองรับงานส่วนใหญ่ที่องค์กรใช้งานจริงได้ดีพอ โดยไม่ต้องพึ่งพาโมเดลระดับ frontier บน cloud เสมอไป ขณะเดียวกัน กฎระเบียบด้านข้อมูล เช่น ข้อกำหนดเรื่อง data residency และกฎหมายคุ้มครองข้อมูลส่วนบุคคลในหลายประเทศ ก็ผลักดันให้องค์กรจำนวนมากต้องพิจารณาการเก็บและประมวลผลข้อมูลไว้ภายในประเทศหรือภายในองค์กรเองมากขึ้น
ผลสำรวจของ NTT DATA ในปี 2026 พบว่ากว่า 95% ขององค์กรมองว่าความเป็นส่วนตัวและอธิปไตยด้านข้อมูล (sovereign AI) มีความสำคัญ และเกือบ 60% ของผู้นำด้าน AI ระบุว่าข้อจำกัดเรื่องการส่งข้อมูลข้ามพรมแดนเป็นอุปสรรคสำคัญต่อการใช้ public cloud
ในขณะเดียวกัน ข้อมูลจาก IDC ระบุว่าภายในปี 2027 องค์กร 80% จะปรับปรุงโครงสร้างพื้นฐาน cloud เดิมให้รองรับงาน AI โดยเฉพาะ และปัจจุบันองค์กรที่มีความพร้อมด้านโครงสร้างพื้นฐานดิจิทัลสูงถึง 64% ระบุว่าระบบของตนเป็นแบบ hybrid อยู่แล้ว
กรอบการตัดสินใจ: ควรวาง Workload ไว้ที่ไหน
ผู้บริหารสามารถใช้ 5 คำถามนี้ประเมินก่อนตัดสินใจว่า workload แต่ละประเภทควรอยู่ local, cloud หรือ hybrid
1. ข้อมูลที่ใช้อ่อนไหวแค่ไหน
ถ้าเกี่ยวข้องกับข้อมูลทางการแพทย์ การเงิน กฎหมาย หรือมีข้อบังคับเรื่อง data residency ให้เอียงไปทาง local หรือ on-premise ทันที เพราะไม่มีนโยบายความเป็นส่วนตัวของผู้ให้บริการรายใดรับประกันได้เท่ากับข้อมูลที่ไม่เคยออกจากระบบภายในองค์กรเลย
2. งานนั้นซับซ้อนแค่ไหน
งานที่เป็น pattern ซ้ำ เช่น สรุปเอกสาร จัดหมวดหมู่ ตอบคำถามจากฐานความรู้ภายใน (RAG) โมเดลขนาดเล็กที่รัน local ก็เพียงพอแล้ว แต่งานที่ต้องใช้การให้เหตุผลหลายขั้นตอน วิเคราะห์เอกสารยาวมาก หรือครีเอทีฟระดับสูง ยังจำเป็นต้องพึ่งโมเดล frontier บน cloud
3. ความเร็วในการตอบสนองสำคัญแค่ไหน
งานที่ต้องการการตอบสนองทันที เช่น ระบบช่วยเขียนโค้ดระหว่างพิมพ์ local ได้เปรียบเพราะไม่มีการส่งข้อมูลไป-กลับผ่านเครือข่าย ส่วนงานที่ต้องสร้างเนื้อหาปริมาณมากในครั้งเดียว cloud มักได้เปรียบด้าน throughput
4. ปริมาณการใช้งานและต้นทุนรวม
สำหรับ workload ที่มีปริมาณสูงต่อเนื่อง (มากกว่า 10 ล้าน token ต่อวัน) การลงทุนรันโมเดลขนาดเล็กเองมักลดต้นทุนรวม (Total Cost of Ownership) ในรอบ 24 เดือนได้อย่างมีนัยสำคัญเมื่อเทียบกับการจ่ายค่า API ต่อเนื่อง แต่ถ้าปริมาณการใช้งานต่ำหรือไม่สม่ำเสมอ รูปแบบจ่ายตามการใช้งานของ cloud ยังคุ้มค่ากว่า
5. องค์กรมีความพร้อมด้านทีมงานหรือไม่
การรันโมเดล local ต้องมีทีมดูแลฮาร์ดแวร์ GPU การอัปเดตโมเดล และการดูแลระบบต่อเนื่อง หากองค์กรไม่มีทีม engineering ที่พร้อม การพึ่งพา cloud หรือ managed service ยังเป็นทางเลือกที่เหมาะสมกว่าในระยะสั้น
ตารางเปรียบเทียบ Local AI vs Cloud AI vs Hybrid
| หัวข้อเปรียบเทียบ | Local AI | Cloud AI | Hybrid |
|---|---|---|---|
| ความเป็นส่วนตัวของข้อมูล | สูงสุด ข้อมูลไม่ออกจากเครื่อง | ข้อมูลถูกส่งไปประมวลผลบนเซิร์ฟเวอร์ผู้ให้บริการ | เลือกได้ว่าข้อมูลไหนอยู่ local ข้อมูลไหนไป cloud |
| คุณภาพโมเดล (reasoning ซับซ้อน) | ตามหลัง frontier ราว 3-6 เดือน แต่ดีพอสำหรับงานทั่วไป | ดีที่สุดสำหรับ reasoning หลายขั้นตอนและ context ยาว | ใช้ frontier เฉพาะงานยาก ที่เหลือใช้ local |
| Latency | ต่ำมาก ไม่มี network round-trip | สูงกว่า แต่ throughput สูงสำหรับงาน generate ยาว | เลือกเส้นทางตามความเร่งด่วนของงาน |
| ต้นทุน | ลงทุนฮาร์ดแวร์ล่วงหน้าสูง ระยะยาว TCO ต่ำกว่าเมื่อใช้งานหนัก | จ่ายตามการใช้งาน คุ้มกับ volume ต่ำ-ปานกลาง | TCO ต่ำกว่า pure cloud ราว 20-30% สำหรับงานหนักต่อเนื่อง |
| ความพร้อมด้านทีมงาน | ต้องมีทีมดูแลฮาร์ดแวร์และโมเดลเอง | ผู้ให้บริการดูแลให้ทั้งหมด | ต้องมีทีมจัดการทั้งสองฝั่งพร้อมระบบ orchestrator |
| ความยืดหยุ่น/การขยายระบบ | จำกัดตามฮาร์ดแวร์ที่มี | ขยายได้แทบไม่จำกัด | ยืดหยุ่นสูงสุด ขยายไป cloud เมื่อ demand พุ่ง |
| การปฏิบัติตามกฎระเบียบ | ตอบโจทย์ data residency ได้ตรงที่สุด | ต้องพึ่งพา compliance certification ของผู้ให้บริการ | ปรับ routing ตามกฎแต่ละประเทศ/ภาคธุรกิจได้ |
| สถานะในปี 2026 | ไม่ใช่แค่ hobbyist แล้ว แต่ยังไม่ใช่ default | ยังครองส่วนแบ่งงานที่ซับซ้อนที่สุด | เป็นรูปแบบ default ขององค์กรขนาดใหญ่ไปแล้ว |
ตัวอย่างองค์กรที่นำไปปรับใช้จริง
อุตสาหกรรมที่มีการกำกับดูแลเข้มงวด องค์กรในกลุ่มสุขภาพ การเงิน และภาครัฐเลือก deploy ระบบเสียงหรือระบบสนทนา AI แบบ local หรือ hybrid มากขึ้น เนื่องจากกฎหมายอย่าง HIPAA หรือข้อกำหนด data residency ไม่อนุญาตให้ส่งบันทึกเสียงหรือข้อมูลลูกค้าไปประมวลผลบนเซิร์ฟเวอร์ของบุคคลที่สาม
สถาปัตยกรรมแบบ “Redact ก่อนส่ง” บางองค์กรใช้แนวทางที่ให้โมเดล local จัดการข้อมูลขาเข้าก่อน โดยลบข้อมูลอ่อนไหว เช่น ชื่อลูกค้าหรือเลขบัญชี ออกก่อน จากนั้นจึงส่งข้อมูลที่ผ่านการปกปิดแล้วไปยังโมเดล cloud ผ่านระบบ orchestrator ที่ประเมินความอ่อนไหวของแต่ละขั้นตอนงานโดยอัตโนมัติ
Hybrid Topology มาตรฐานในองค์กรขนาดใหญ่ รูปแบบที่พบบ่อยคือการใช้โมเดล frontier บน cloud สำหรับงานที่ต้องการการให้เหตุผลซับซ้อน ควบคู่กับการ deploy โมเดลขนาดเล็กส่วนตัวบนกลุ่มเซิร์ฟเวอร์ภายในองค์กรสำหรับงานที่เกี่ยวข้องกับข้อมูลอ่อนไหว เป็นการใช้ทรัพยากร cloud ราคาแพงเท่าที่จำเป็นจริงๆ เท่านั้น
Edge AI ในภาคการผลิตและโลจิสติกส์ โรงงาน ร้านค้าปลีก และธุรกิจโลจิสติกส์เริ่มรัน AI โดยตรงที่จุดเกิดข้อมูล เช่น หน้างานโรงงานหรือกล้อง IoT เนื่องจากต้องการ latency ที่ต่ำมากและบางพื้นที่ไม่มีการเชื่อมต่ออินเทอร์เน็ตที่เสถียรตลอดเวลา
ข้อควรระวังสำหรับผู้บริหาร
งานวิจัยหลายแห่งชี้ว่าโครงการ AI ขององค์กรจำนวนมากยังติดอยู่ในขั้น Proof-of-Concept และไม่สามารถขยายผลสู่การใช้งานจริงได้ สาเหตุหลักมักไม่ได้อยู่ที่ตัวโมเดล แต่เป็นเรื่องการขาดตัวชี้วัดที่ชัดเจน ข้อมูลภายในที่ไม่เป็นระเบียบ และการนำเครื่องมือ AI เข้ามาใช้มากเกินความจำเป็นจนเกิดความล้าในการปรับตัวของทีมงาน
ข้อแนะนำเชิงปฏิบัติคือ เริ่มจากการกำหนดตัวชี้วัดที่แคบและวัดผลได้ชัดเจน เช่น ลดจำนวนคำร้องขอความช่วยเหลือลง 40% หรือเร่งความเร็วในการส่งมอบงานบางประเภท แทนที่จะตั้งเป้าหมายกว้างๆ ว่า “นำ AI มาใช้ทั่วองค์กร”
สรุป
Local AI จะไม่มาแทนที่ Cloud AI ทั้งหมด และ Cloud AI ก็จะไม่ครองพื้นที่ทั้งหมดเช่นกัน สิ่งที่กำลังเกิดขึ้นจริงในปี 2026 คือสถาปัตยกรรมแบบ Hybrid ที่วาง workload แต่ละประเภทไว้ในตำแหน่งที่เหมาะสมที่สุด โดยพิจารณาจากความอ่อนไหวของข้อมูล ความซับซ้อนของงาน ต้นทุน และความพร้อมของทีมงาน
สำหรับผู้บริหารองค์กร คำถามที่ควรถามจึงไม่ใช่ “เราควรเลือก local หรือ cloud” แต่เป็น “workload ของเราแต่ละประเภทควรอยู่ที่ไหน” และองค์กรที่เริ่มวางกรอบการตัดสินใจนี้ตั้งแต่วันนี้ จะได้เปรียบทั้งด้านต้นทุน ความปลอดภัยของข้อมูล และความสามารถในการปรับตัวเมื่อกฎระเบียบหรือเทคโนโลยีเปลี่ยนแปลงในอนาคต
 Lenovo V15 G5 i5-13420H/16GB/512GB SSD/15.6″/DOS (83HF00CWTA)